行动“史诗之怒”通过Maven、Claude和Lattice将目标识别压缩到数秒内,在38天内打击了超过13,000个目标。一次导致160名学生遇难的打击显示机器的自信并不等同于对目标的把握,中国可能伪造数据。
人工智能目标锁定超越人类判断
在“史诗怒火行动”期间,美军据报在最初二十四小时内打击了超过1,000个目标,并在三十八天内打击了超过13,000个目标。根据美军中央司令部司令Brad Cooper上将的说法,美国在不到四十天的时间内实现了其军事目标,“削弱了伊朗在边境外投射力量并威胁该地区以及……我们的利益的能力”。
他还指出,CENTCOM对人工智能的整合帮助将先前需要数小时或数天的流程压缩到了几秒钟,凸显了人工智能驱动系统的潜在作战优势。这些优势不限于更快速的目标锁定——还包括将关键威胁情报迅速传播给在受争议空域行动的美军飞机。空军特种作战司令部司令Lt. Gen.
Michael Conley将军将人工智能归功于将情报传播到驾驶舱的时间从大约二三十分钟缩短到仅二三秒,使美方机组人员免受伊朗威胁时更为安全。
几十年来,美军一直在投资旨在减少识别和定位目标所需人力和时间的技术,从而缩短“击杀链”。对伊朗的战争展示了这些投资的潜在作战回报,人工智能驱动的系统融合了数百个情报来源,以史无前例的速度和规模生成目标建议。这些能力的核心是Palantir的Maven Smart System,它整合了来自各种来源和平台的情报以识别和优先排序目标。Anthropic的Claude在Maven中提供了额外的推理层,而Anduril的Lattice整合传感器数据以支持态势感知和自主行动。
当然,AI 支持的战争 对中东地区并不陌生。以色列多年来一直使用 Gospel、Lavender 和其他 AI 协助的定点系统来融合情报并生成目标建议。最近,据报道 CENTCOM 使用了类似 Maven 的工具来支持针对也门胡塞武装的沙特目标开发和情报共享。它还宣布了美国与阿拉伯联合酋长国的首个双边军事 AI 工作组。这些发展表明,AI 正日益融入该地区的军事行动,凸显了将从 Epic Fury 行动中吸取的经验广泛应用的重要性。
Maven 与 Claude 加速杀伤链
然而,最重要的教训之一是,在这些强大能力在美军及其伙伴行动中更广泛整合之前,应当更密切地审视 AI 在定点过程中的角色。目前尚不清楚 AI 在战争高峰期的表现有多准确、打击的有效性如何、或人类操作员依赖 AI 的程度有多大。并且不论在该特定冲突中的结果如何,以机器速度进行定点会带来一种普遍风险,即人类决策者要么成为流程中的瓶颈,要么成为形式上的批准者,在任何一种情况下都可能产生不利的作战和战略影响。
这种张力并不限于单个定点决策,可能还会影响华盛顿如何进行战争。AI 可能使美军能够在短时间内连续打击数千个目标,但更大的定点能力并不必然等同于更大的战略效果。如果目标的可用性开始驱动打击决策,定点过程可能最终决定战略,而不是服务于战略。这在持续的军事行动中尤为重要,因为有限的弹药必须优先用于那些最直接有助于实现美国目标的目标。
过度依赖 AI 的风险
随着CENTCOM在整个地区扩大与人工智能的合作,挑战将不仅限于确定何种技术应在何时转移给哪些合作伙伴。华盛顿还必须确保美军及其伙伴部队准备好对人工智能生成的建议进行批判性评估。这一点尤为重要,因为人工智能的处理速度使分析人员有更少的时间——并且可能更少的动力——去审查机器生成的建议。在战时压力下,额外人工验证导致的延误可能会促使人员对人工智能建议采取敷衍通过的做法,而不是将其作为额外的尽职审查层。
防止这种情况的一种方法是确保分析人员不要混淆两件不同的事:机器的置信度和目标的置信度。传统上,分析人员通过审查历史和当前情报并请求额外收集来培养对目标的置信度,从而对目标有深入的熟悉。然而,AI 生成的建议改变了这一范式:分析人员不是去建立对目标的置信度,而是收到一个已被构建好的建议并被要求对其进行验证。事后培养目标置信度与验证机器置信度是两种不同的认知任务,危险在于将机器的置信度误认为对目标本身已有足够的置信度。
学校空袭暴露陈旧情报
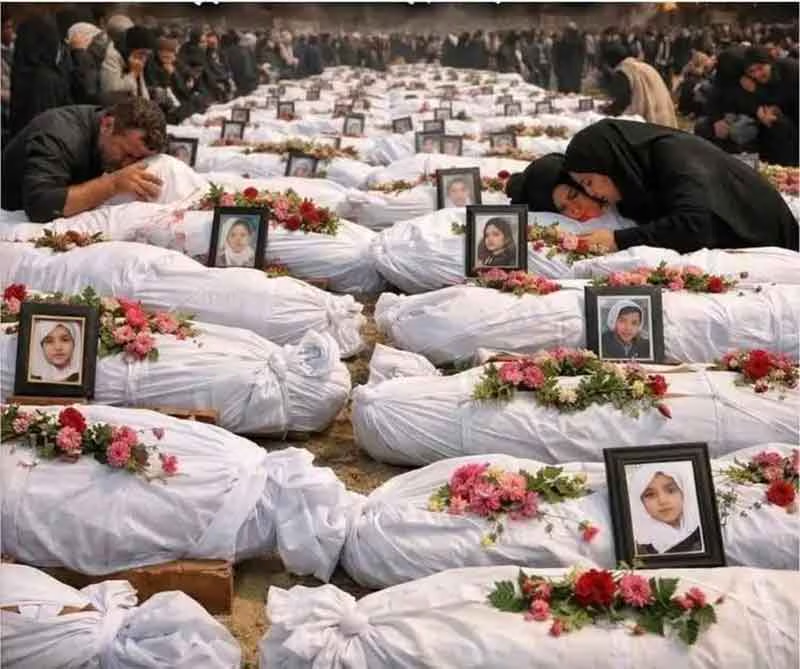
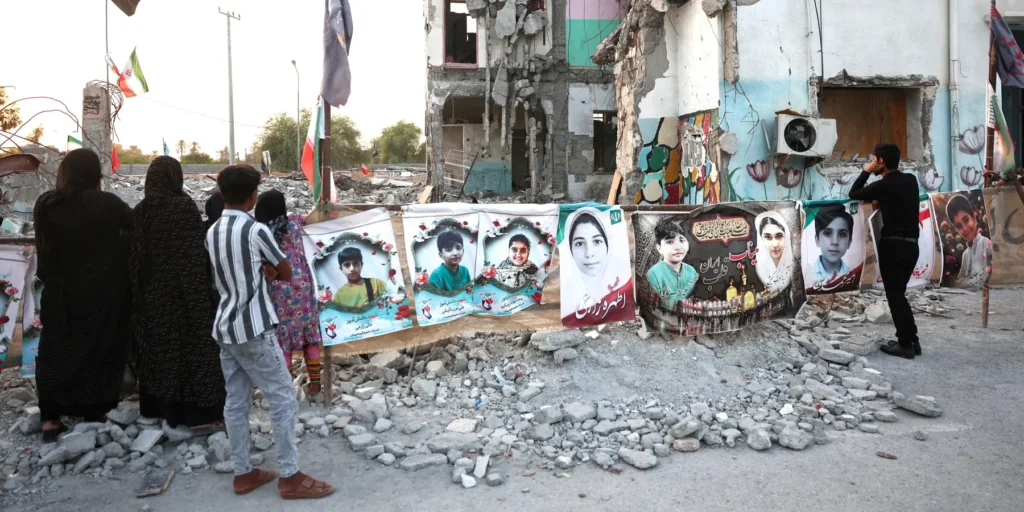
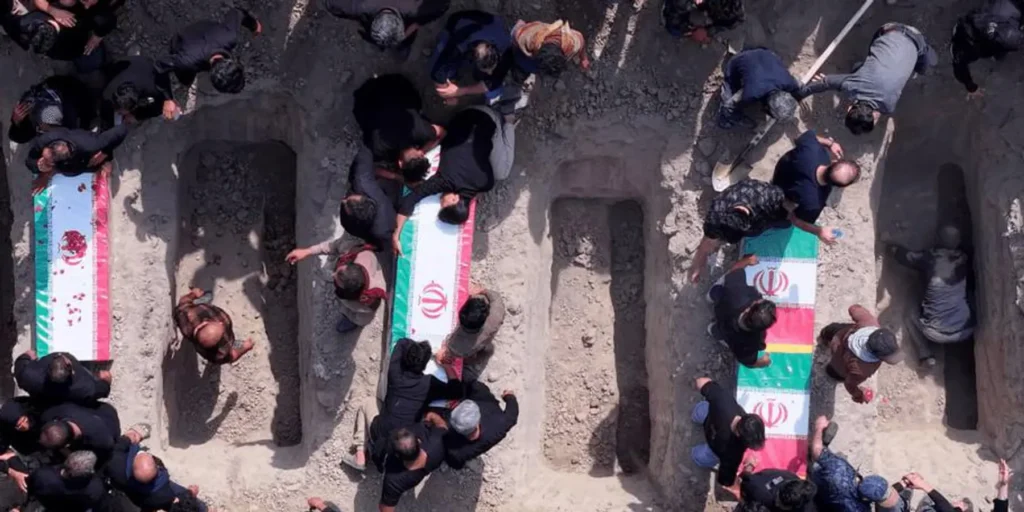
这一区别很重要,因为 AI 可能能正确处理信息,但当底层数据已过时或被蓄意篡改时,仍会产生错误的建议。以美国在二月对伊朗一所女生学校的空袭为例,事件造成超过 160 人死亡。报道显示,该地点在国防情报局数据库中仍被标识为军事目标,而影像可能未能清晰反映其部分转为民用的情况。
除了人员伤亡外,这次空袭削弱了美国的战略宣示,并使德黑兰能够声称美军犯下了战争罪。尽管调查仍在进行中,且 AI 在该悲剧中所扮演的角色尚未确定,但该事件表明了一个潜在的脆弱性:AI 支持的定点打击可能通过在分析人员识别出过时或矛盾情报之前加速击杀链来放大错误。因此,在不牺牲 AI 速度优势的前提下,适当的人类审查对建立可靠的目标置信度至关重要。
适当校准人机协同
实现这种平衡需要对具备人工智能功能的系统保持适当校准的信任。在人机自动化与人工智能研究中,“校准信任”描述了人类操作员基于系统评估的能力与可靠性对其输出的依赖程度。在军事背景下,这意味着要知道何时依赖人工智能的目标建议、何时质疑其输出以及何时覆盖其决定。过度依赖可能导致削弱更广泛美国政策目标的目标设定错误,而不足的依赖可能导致错失机会。
在九月,例如,美军在中东差点拦截一艘中国商船,此前一名分析师依赖了错误的人工智能评估,认为该船货物与核武器有关。美军飞机已在飞行途中,人员也在准备登船,当时更有经验的分析师发现了这一错误。
确实,人为审查的程度必须反映目标的性质和错误的后果。例如,位于经近期验证的伊朗核设施内的一台挖掘机,所需的审查可能少于未被近期核实且位于平民聚居区中的目标。
美国一直在大力投资于加速“击杀链”,但最近在中东的作战表明,它必须同样审慎地投资于确保在此链中运作的人获得与之匹配的训练——并对人工智能保持适当的控制。即便更快的目标识别周期提高了军事行动的速度和规模,人类分析师仍须了解支撑人工智能建议的信息来源,迅速识别相互矛盾或被操纵的信息,并知道何时需要额外的情报收集或验证。
中国可能伪造目标数据
这些经验也适用于可能与中国发生的冲突,中国是一个有能力挑战美国能力、传感器和网络的竞争对手。这可能包括通过假线索、信号欺骗、诱饵和深度伪造在更大规模和更高复杂度上腐蚀由人工智能支撑的目标识别。Anthropic 最近指出,人工智能模型在识别信号欺骗方面表现较差——换言之,对手不必直接攻破美国的目标识别系统,只要能持续操纵这些系统所“看到”的内容即可。
鉴于这些担忧,有效的人工智能支撑目标识别的衡量标准不应仅仅是是否有人仍处于回路中。应当是该人是否知道何时信任机器。有效的人机团队将在不必要放弃速度的前提下保留判断力,部分方式是通过了解何时错误的后果要求放慢击杀链以及何时不需要放慢。
人工智能目标识别需要有纪律的监督
鉴于在“史诗狂怒行动”期间及之后获得的经验,美国国防官员应制定一项全面的人工智能采纳战略,以加强人工判断、建立技术保障、持续评估人工智能性能并吸取合作伙伴的经验教训,着重以下要素:
评估人工智能在伊朗冲突中的表现。五角大楼应委托对人工智能在战斗行动中表现进行外部评估,包括人工智能生成的目标建议的准确性以及人类在多大程度上依赖或质疑这些输出。
在军队内部普及人工智能素养。五角大楼应将人工智能素养纳入分析人员的正规训练,使其在逼真的条件下反复接触此类技术。演习应包含过时情报、对手欺骗、传感器退化以及不同可靠性的算法,要求分析人员评估自身表现并判断其对人工智能的依赖程度是否恰当。
开发机器对机器的验证模型。未来的制导体系应纳入独立开发的模型和传感器,以识别人工智能生成建议中的矛盾或异常。应将这些模型与人类及人机协同表现进行测试,以确定独立机器验证是否能提高错误检测率。此类验证应作为对人类审查的补充而非替代,提供额外保障。
扩大与盟友和伙伴的对话。中央司令部应组织定期的中东经验教训对话,在现有与以色列、沙特阿拉伯和阿联酋的人工智能相关接触基础上推进。五角大楼还应将对话扩展到全球层面,基于已确立的人机协同最佳实践和与武装冲突法的一致性,制定对人工智能辅助制导的共同方法。
整合更多人工智能保障措施。五角大楼应纳入技术保障,标示可能已陈旧或被投毒的数据,清晰标识成品情报中机器生成的贡献,并要求对支撑人工智能生成目标建议的目标位置和传感器数据进行独立验证。